Близо 25% от потребителите ще изоставят вашата дигитална услуга или онлайн магазин при първото по-сериозно забавяне и ще отидат директно при конкурента ви. Ако ИТ инфраструктурата ви е разпокъсана и не е оптимизирана, ИТ екипът ви ще прекара 33% повече от работното си време в “гасене на пожари” – отстраняване на сривове и ръчни проверки. Ако пък се наложи да плащате за извънреден труд или външни консултанти, това ще натовари бюджета ви за ИТ с между 25 и 50%.
Тези данни не целят да ви плашат, а да ви покажат един скрит източник на финансови течове, които можете да намалите драстично, ако не и да спрете напълно. Нека обаче започнем от проблема – неправилно проектирана ИТ инфраструктура.
Капанът на краткосрочното планиране и „купуването на парче“
Един сигурен начин да се озовете в гореспоменатия сценарий е да подходите към изграждането на мрежата “на парче”. Това произтича от стремежа да се решат само текущите нужди, а бъдещите да се оставят за по-късно.
„Много често, за съжаление, повечето потребители не се замислят какво биха желали да постигнат от своята инфраструктура и какво очакват от нея за следващите месеци и години. Прилага се подходът „да решим текущите нужди, а бъдещите ще ги посрещнем евентуално завбъдеще, което е изцяло грешно.“ Това коментира Андон Андонов, консултант “Предпродажби” за България, Северна Македония, Албания и Косово в Fsas Technologies, в подкаста ТЕХнически погледнато: Защо устойчивата ИТ инфраструктура започва с правилния дизайн. В епизода той заедно с техническия директор на “АОСИА България” Ивайло Петров споделят ключови наблюдения за това как комбинацията от дисковите среди на NetApp и софтуера FSAS Infrastructure Manager (ISM) променя начина, по който компаниите управляват данните си и гарантират непрекъсваемост на бизнеса.
Загуби със скорост $1 млн. в час
В крайна сметка неправилно проектираната ИТ инфраструктура често води до непредвиден престой и системни сривове. Според международното изследване Hourly Cost of Downtime Survey на независимата аналитична агенция ITIC, за 91% от средните и големите компании цената на един час непредвиден престой надхвърля $300 000. При 41% от водещите корпорации (в сектори като финанси, здравеопазване и търговия) щетите за едва 60 минути извън мрежата достигат между $1 и $5 милиона.
Данните се потвърждават и от Gartner (Cost of Downtime Analysis), където средната цена на престоя се оценява на $5 600 на минута за малки и средни организации, а анализите на IDC сочат, че при компании от Fortune 1000 критичните сривове в инфраструктурата струват средно между $500 000 и $1 милион на час.
От хаоса на изобилието до “евтиното излиза скъпо”
Според Ивайло Петров при изграждането на ИТ среда компаниите изпадат в две крайности. Във варианта “бюджети без стратегия” организации с големи възможности често купуват най-скъпия хардуер и софтуер с надеждата, че той автоматично ще реши проблема. Натрупват се сложни решения от десетки доставчици, а крайният ефект върху бизнес ефективността е отрицателен.
Другата крайност е да се постигне огромна сложност поради ниска цена. Когато в дадена компания липсват квалифицирани кадри или достатъчно бюджет, по-малките фирми избират най-евтините модули от различни производители. Без централизиран инструмент това създава фрагментирана инфраструктура, чието поддържане отнема огромен ресурс.
“При частните облаци основата е бърза мрежа и бърз сторидж. Ако тези две неща ги няма, колкото и да го умножавате всичко останало, няма да ви даде правилния резултат.“, каза Ивайло Петров.
Какво представлява Infrastructure Manager и защо е създаден
Решението на проблема с разнородната инфраструктура не е да изхвърлим всичко и да започнем отначало. То се крие в една проста дума – управление. Fsas Technologies имат специална разработка, която прави точно това – дава цялостен поглед върху инфраструктурата и отделните взаимовръзки между елементите. Тя е създадена, за да опрости ежедневното администриране както на локални, така и на географски разпределени среди от множество дейта центрове.
Зад съкращението ISM стои Infrastructure Manager. “Разработката идва пряко свързана с потребителските нужди, тъй като съвременните центрове за данни стават все по-комплексни. Използваме разнообразни типове устройства, виртуализационни платформи и става все по-трудно на администраторите да свършват ежедневните си задачи бързо и качествено.“, разказа Андон Андонов.
По неговите думи управлението от единна конзола, каквато представлява ISM, помага много по-бързо да бъде диагностициран потенциално възникнал проблем.
“В продукта сме вложили и елементи, базирани на изкуствен интелект, които спомагат да открият потенциални проблеми преди те да са възникнали и изграждат препоръки към администратора какво да предприеме.“, допълни той.
Защо ISM трябва да се вкара още при дизайна
“Когато имате множество сървъри – 3, 5, 20, 100, а да не говорим 1000, е почти невъзможно да се ъпдейтват или да се покрие това управление без централизиран софтуер.“, смята Ивайло Петров.
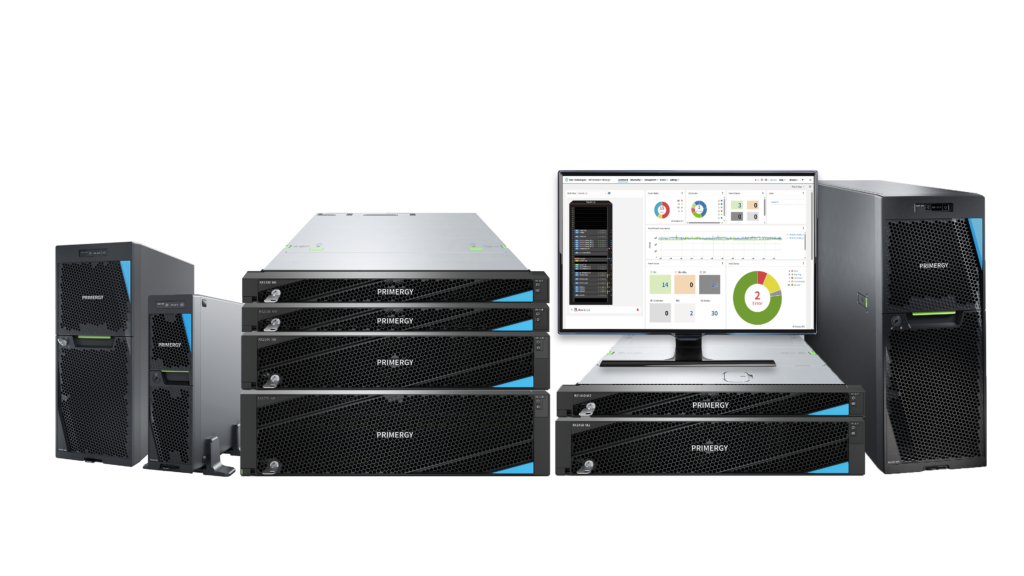
Софтуерът обхваща управлението не само на цялата гама устройства на Fujitsu, но и на редица други производители. “Има стандартен SNMP протокол и визуално имате възможност да видите как изглежда целият рак. Днес много малко софтуери го показват и позволяват да наблюдавате едно към едно вашия дейта център.“, допълни той.
ISM поддържа масово инсталиране на операционни системи (Mass OS installation), автоматично засичане на нови възли (auto-discovery) и еднократно създаване на конфигурационни профили за бързо разгръщане. Освен това предоставя Single Sign-On (SSO) до управляваните сървъри, одит на потребителски действия, поддръжка на Active Directory / OpenLDAP и сигурни актуализации на фърмуер.
Пълна видимост и превантивен мениджмънт с ISM
Много често ИТ администраторът разбира за проблем едва когато потребителите или клиентите започнат да се оплакват от срив или бавна работа. Infrastructure Manager променя това, като осигурява централизиран контрол от единна конзола за целия дейта център. По този начин позволява потенциалните проблеми да се посрещат и решават проактивно.
- Централизиран поглед върху цялата среда: ISM дава 1:1 визуално съответствие на оборудването в раковете и управлява хардуерно и виртуално ниво за FSAS/Fujitsu сървъри, Cisco мрежи, NetApp сториджи и VMware среди.
- Вграден AI за предиктивна диагностика: Алгоритмите откриват тесни места в мрежата, анализират съвместимостта на фърмуери и драйвери и предупреждават за липсващи пачове за сигурност, преди да настъпи срив,.
- Бързо изолиране на физически дефекти: ISM идентифицира локацията на проблеми чак до конкретен порт, сървър или кабел.
Да поговорим за пари – ROI от правилния ИТ дизайн
Според изчисления на DataBank, инвестицията в предварително проектирана, централизирана и устойчива инфраструктура генерира над 250% ROI само от спестени загуби. При изграждането на дизайн “на парче” специалистите прогнозират среден годишен риск от загуби поради 3–4 престоя на година от около 1.8 милиона долара. При правилно проектирания частен облак (99.999% наличност) очакваният годишен риск от загуби е под 30 000 долара.
„Имахме клиент, чиято инфраструктура беше криптирана – над 200ТВ данни. Помогнахме му да възстанови всичко за 4–5 дни и след това подобрихме дизайна си. Днес с правилната сторидж архитектура и автоматизация гарантираме на клиентите ни, че до 72 часа им възстановяваме цялата инфраструктура при инцидент, а тестовете ни показват под 8 часа.“, разказа Ивайло Петров.
ISM се предлага в две версии – ISM Essential (Безплатна версия) и ISM Advanced (Пълнофункционална версия). Първата осигурява входно ниво за стандартно управление на единични среди и предоставя основни функционалности за мониторинг на здравето на системата (health monitoring), инвентаризация, събития и актуализация на фърмуер. По-високата версия е предназначена за мащабни среди и множество дейта центрове. Включва централизирано табло (dashboard), профили за автоматизация, управление на фърмуер базови линии (firmware baselines) и нативна интеграция с платформи като VMware, Microsoft System Center и Ansible.
Стратегически хоризонт за инвестициите
При изграждането на ИТ инфраструктура днес минималният хоризонт за устойчивост трябва да бъде планиран за години напред, като се разчита на скалируемост и надеждни партньори.
„Като правим дизайн на нова инфраструктура, той трябва да е такъв, че да е устойчив във времето и да не зависи от отделните компоненти. Трябва да ни позволява да добавяме нови ресурси и да изваждаме остарелите по начин, който не налага спиране, престой или изучаване на нови технологии, забавящи процеса“, каза Андон Андонов.
Ивайло Петров коментира, че концепцията на “АОСИА България” е “ако може, да не се подменя нищо”. “Затова първоначално отделяме адски много внимание на качеството. Досега всичките ни частни облаци, които сме направили, са с хоризонт минимум 6 до 9 години. Имаме инфраструктура, която е на 13 години и работи безпроблемно“, допълни той.